Llevar la inteligencia artificial a la planta de producción, a un vehículo o a una cámara de inspección ya no es algo del futuro o un experimento, sino una realidad. Pero cuando llega el momento de elegir un ordenador Edge AI, la mayoría de equipos de compras se encuentra con la misma trampa: comparar fichas técnicas por un único número, los TOPS, y descubrir meses después que el sistema se queda corto de memoria, se calienta en el armario o no cumple la latencia que exigía el proceso.
En esta guía te explicamos, paso a paso, cómo dimensionar el hardware para inferencia en el edge: qué significan realmente los TOPS, cuándo conviene una NPU y cuándo una GPU, cuánta memoria y almacenamiento necesitas y cómo evitar que la refrigeración arruine tu proyecto.
Por qué dimensionar bien un equipo Edge AI
A diferencia de un servidor en la nube, un equipo en el borde trabaja con restricciones duras: espacio limitado, presupuesto energético ajustado, temperaturas ambientes elevadas, vibraciones y, a menudo, funcionamiento 24/7 sin intervención humana. Un equipo infra dimensionado pierde fotogramas o decisiones; uno sobredimensionado multiplica coste, consumo y calor sin aportar valor.
El objetivo no es el equipo más potente, sino el más ajustado a tu carga de trabajo con un margen razonable.
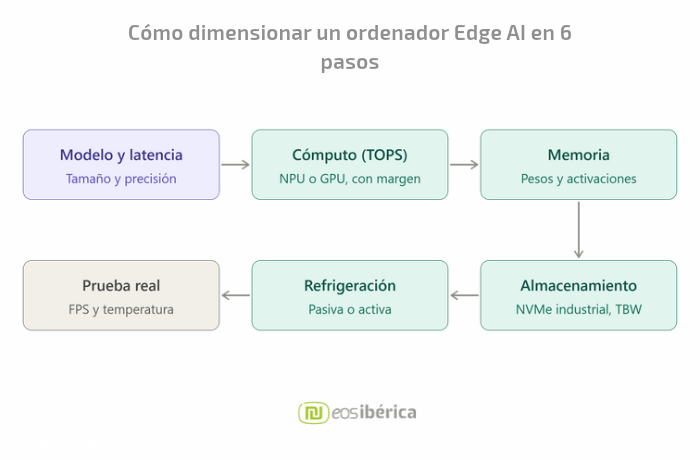
Paso 1: empieza por el modelo, no por el hardware
Antes de mirar procesadores, define cuatro datos:
- Tipo de modelo: detección de objetos (YOLO y derivados), clasificación, segmentación, reconocimiento de voz, detección de anomalías o modelos de lenguaje compactos (SLM/LLM cuantizados). Cada familia tiene necesidades de cómputo y memoria muy distintas.
- Tamaño del modelo: número de parámetros y precisión (FP32, FP16, INT8, INT4).
- Entrada de datos: cuántos flujos de vídeo o sensores, a qué resolución y a cuántos fotogramas por segundo.
- Latencia objetivo: ¿basta con responder en 200 ms o necesitas menos de 20 ms para actuar sobre una línea en movimiento?
Con estos datos puedes estimar el cómputo necesario. Una regla práctica: multiplica las operaciones por inferencia del modelo (que suele indicar el fabricante o el propio framework) por las inferencias por segundo que necesitas, y añade un margen del 30-50 % para el preprocesado, el posprocesado y los picos.
Paso 2: entender los TOPS (y sus trampas)
Los TOPS (Tera Operations Per Second) indican billones de operaciones por segundo y son la métrica estrella al comparar aceleradores. Son útiles, pero hay que leerlos con cautela:
- Son cifras pico teóricas. El rendimiento real depende del modelo, de las capas que el acelerador soporta y del ancho de banda de memoria.
- Dependen de la precisión. Lo habitual es que se publiquen en INT8 (o incluso INT4). Si tu modelo corre en FP16, el rendimiento efectivo será menor.
- A veces incluyen sparsity. Algunas cifras asumen estructuras dispersas en el modelo que no todos los modelos aprovechan.
- Pueden sumar varios motores. Hay fichas que suman CPU, GPU y NPU en un solo número, algo que rara vez se traduce en una sola carga de trabajo real.
Como orientación, los aceleradores para el borde se mueven en rangos como estos:
| Rango de TOPS | Casos típicos |
|---|---|
| 4-6 TOPS | Visión sencilla, clasificación, detección con pocas cámaras, voz. |
| 4-100 TOPS | Detección multicámara, seguimiento, inspección de calidad en tiempo real. |
| 100 – 275+ TOPS | Múltiples flujos de alta resolución, robótica, modelos más pesados o IA generativa compacta. |
Son rangos orientativos: valídalos siempre con una prueba de concepto con tu propio modelo. Los benchmarks reales (fotogramas por segundo y latencia por inferencia) valen más que cualquier cifra de catálogo.
Paso 3: GPU vs NPU, ¿Cuál elegir?
La decisión entre GPU y NPU es la más importante del dimensionado, y no hay una respuesta universal.
La NPU (NPU, Unidad de Procesamiento Neuronal) es un acelerador diseñado específicamente para operaciones de redes neuronales. Su gran ventaja es la eficiencia energética: ofrece muchos TOPS por vatio, lo que la hace ideal para equipos compactos, sin ventilador o con presupuesto térmico limitado. Su límite es la flexibilidad: soporta bien los operadores más comunes, pero los modelos muy novedosos o con capas poco habituales pueden requerir adaptación o no ejecutarse al 100 % en la NPU.
La GPU es más versátil y ofrece un ecosistema de software maduro (CUDA, TensorRT, entre otros). Gestiona modelos grandes, arquitecturas nuevas, varios modelos en paralelo y también tareas gráficas o de entrenamiento ligero. A cambio, consume más y disipa más calor.
| Criterio | NPU | GPU |
|---|---|---|
| Eficiencia (TOPS/W) | Muy alta | Media-Alta |
| Consumo típico | Bajo | Medio-Alto |
| Flexibilidad de modelos | Limitada a operadores soportados | Muy alta |
| Ecosistema de software | En crecimiento, según fabricante | Maduro |
| Formato habitual | Integrada en el Soc o módulo M.2 | Integrada, módulo o tarjeta dedicada |
| Ideal para | Visión estándar, 24/7, equipos compactos | Modelos grandes, multimodelo, IA generativa, prototipado |
Criterio rápido: si tu modelo es estándar, está cuantizado y el consumo manda, empieza por una NPU. Si necesitas flexibilidad, modelos grandes o vas a iterar mucho, una GPU te dará más margen. En muchos proyectos la mejor opción es híbrida: NPU para la carga fija y continua, GPU para lo demás.
Si estás en fase de preparar y reentrenar modelos propios, te será útil nuestra guía sobre componentes industriales para entrenar tu propia inteligencia artificial.
Paso 4: memoria RAM y ancho de banda
La memoria es el cuello de botella más infravalorado. Dos factores cuentan: capacidad y ancho de banda.
Capacidad. Una estimación inicial para los pesos del modelo:
memoria de pesos ≈ nº de parámetros × bytes por parámetro
Por ejemplo, un modelo de 7.000 millones de parámetros ocupa unos 14 GB en FP16, unos 7 GB en INT8 y alrededor de 3,5-4 GB en INT4. A esto debes sumar activaciones, buffers de vídeo, el sistema operativo y, en modelos de lenguaje, la caché de contexto, que crece con la longitud de la conversación.
Ancho de banda. En la inferencia, sobre todo con modelos de lenguaje, el rendimiento suele estar limitado por la velocidad a la que se leen los pesos desde la memoria, no por los TOPS. Dos equipos con los mismos TOPS pueden rendir muy distinto si uno tiene memoria unificada de alto ancho de banda y el otro una DDR más lenta.
Recomendaciones prácticas:
- Para visión con modelos pequeños o medianos, 8-16 GB suelen ser suficientes.
- Para multicámara o varios modelos simultáneos, 16-32 GB.
- Para IA generativa local, 32 GB o más, según el tamaño del modelo y su cuantización.
- Deja siempre un 20-30 % de margen libre.
Ten en cuenta que en muchas plataformas Edge AI, como las basadas en módulos NVIDIA Jetson Orin, la memoria es integrada y unificada (la comparten CPU y GPU) y no se puede ampliar después. La capacidad hay que elegirla bien desde el principio.
Paso 5: almacenamiento
El almacenamiento parece secundario, pero afecta al arranque, a la carga de modelos y a la fiabilidad a largo plazo.
- NVMe frente a eMMC o SATA: un SSD NVMe reduce tiempos de carga de modelos y de escritura de datos. Es la opción recomendada para cargas exigentes.
- Capacidad: suma sistema, modelos (y sus versiones), registros y, si grabas, el vídeo o los datos que se conservarán hasta su sincronización con la nube o el servidor central.
- Resistencia (TBW) y rango de temperatura: en entornos industriales, elige SSD con grado industrial, protección ante cortes de energía y amplio rango térmico. Un disco de consumo puede fallar mucho antes si escribe constantemente.
- Redundancia: si el equipo es crítico, valora dos unidades o una estrategia de actualización segura (A/B) para recuperar el sistema tras un fallo.
Paso 6: refrigeración y consumo
Un procesador potente en un chasis mal refrigerado acabará reduciendo su frecuencia (thermal throttling) y entregando menos rendimiento del que prometía la ficha técnica. Dimensionar el sistema térmico es parte del dimensionado de cómputo.
- Presupuesto de potencia (TDP): suma el consumo del procesador, el acelerador, la memoria, el almacenamiento y los periféricos. Revisa la fuente de alimentación y el rango de tensión admitido, especialmente en vehículos o instalaciones con alimentación variable.
- Refrigeración pasiva (sin ventilador): ideal para entornos con polvo, vibración o vida útil larga, ya que elimina una pieza móvil. Funciona bien hasta cierto TDP; más allá, el chasis necesita aletas amplias o disipación asistida.
- Refrigeración activa: permite más potencia en menos volumen, pero exige mantenimiento y filtrado del aire.
- Temperatura ambiente: diseña para el caso peor, no para el medio. Un equipo en un cuadro eléctrico al sol puede superar fácilmente los 50 °C ambiente. Comprueba el rango de temperatura de operación declarado y a qué carga se garantiza.
- Medir, no suponer: mide la temperatura y las frecuencias durante una prueba de carga sostenida de varias horas, no solo en los primeros minutos.
Para proyectos donde el espacio es crítico, los mini PC industriales para proyectos compactos y edge computing ofrecen chasis robustos con refrigeración pasiva y amplio rango de temperatura pensados para este tipo de despliegues.
Tres ejemplos de dimensionado
- Inspección visual en línea de producción (2-4 cámaras, detección de defectos). Modelo de detección cuantizado a INT8, latencia por debajo de 50 ms. Una NPU de gama media o un módulo con GPU compacta, 16 GB de RAM, NVMe industrial de 256-512 GB y refrigeración pasiva. Prioridad: estabilidad 24/7.
- Videovigilancia inteligente en planta o ciudad (8-16 flujos). Muchos flujos de vídeo, decodificación por hardware y varios modelos (detección, seguimiento, reconocimiento). Una GPU o un acelerador de alta gama, 32 GB de RAM y almacenamiento ampliable para grabación. Prioridad: ancho de banda y capacidad de decodificación.
- Asistente de IA generativa local (SLM/LLM cuantizado). Modelo de lenguaje de 3-8 B parámetros en INT4/INT8, sin enviar datos a la nube. GPU o memoria unificada de alto ancho de banda, 32 GB o más, NVMe rápido y refrigeración con margen. Prioridad: memoria y ancho de banda, no sólo TOPS.
Dos equipos de EOS Ibérica para empezar
Para los casos de visión y computación en el borde de gama media, EOS Ibérica ofrece dos PC industriales basados en NVIDIA Jetson Orin, con el mismo planteamiento de robustez y distinto nivel de cómputo.
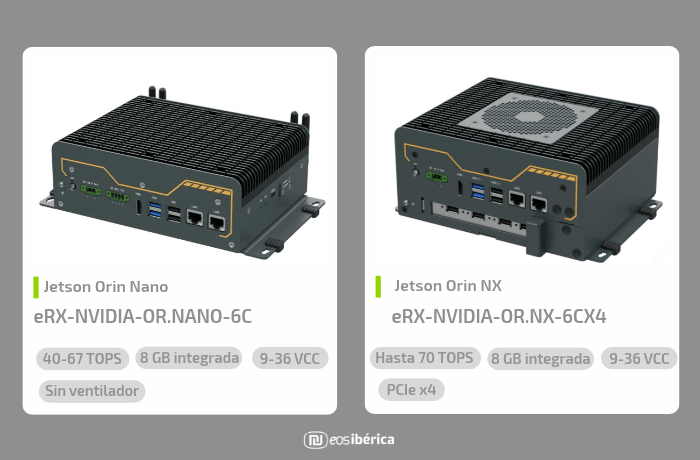
| Característica | eRX-NVIDIA-OR.NANO-6C | eRX-NVIDIA-OR.NX-6CX4 |
|---|---|---|
| Módulo | NVIDIA Jetson Orin Nano | NVIDIA Jetson Orin NX |
| CPU | ARM de 6 núcleos | ARM de 6 núcleos |
| Rendimiento de IA | 40-67 TOPS | Hasta 70 TOPS |
| Memoria | 8 GB integrada | 8 GB integrada |
| Alimentación | 9-36 VCC | 9-36 VCC |
| E/S y expansión | Múltiples opciones de E/S | E/S multicanal y expansión PCIe x4 |
| Aplicaciones | Transporte inteligente, visión artificial, logística, MEC | Transporte inteligente, visión artificial, logística, MEC |
El eRX-NVIDIA-OR.NANO-6C es un equipo sin ventilador pensado para cuando el consumo y la robustez mandan: pocas cámaras, modelos de detección cuantizados y funcionamiento continuo en entornos con polvo o vibración. Encaja con el primer ejemplo de esta guía.
El eRX-NVIDIA-OR.NX-6CX4 sube el techo de cómputo hasta 70 TOPS y añade expansión PCIe x4, una buena opción si necesitas más flujos de vídeo, varios modelos a la vez o ampliar el sistema con hardware adicional.
En ambos casos la memoria es de 8 GB y no es ampliable, así que son ideales para visión y modelos compactos, pero conviene validar con tu modelo si necesitas más margen (varios flujos simultáneos o modelos de lenguaje grandes). Y recuerda: los TOPS son cifras pico, así que lo recomendable es hacer una prueba con tus propios datos antes de decidir.
Lista de verificación antes de elegir
- ¿Conozco el modelo, su precisión y el cómputo por inferencia?
- ¿Está definida la latencia máxima y los FPS necesarios?
- ¿Los TOPS del catálogo están expresados en la precisión que voy a usar?
- ¿La NPU o GPU soporta todas las capas de mi modelo?
- ¿Tengo memoria suficiente para pesos, activaciones y búfer, con un 20-30 % de margen?
- ¿El almacenamiento es industrial, con la resistencia y capacidad adecuadas?
- ¿He validado el comportamiento térmico a la temperatura ambiente más desfavorable?
- ¿He probado un prototipo con datos reales antes de escalar?
Conclusión
Dimensionar un ordenador Edge AI consiste en equilibrar cuatro variables: cómputo (TOPS), memoria, almacenamiento y térmica, todas condicionadas por tu modelo, tu latencia y tu presupuesto de consumo. Una NPU suele ganar en eficiencia y una GPU en flexibilidad; los TOPS son un punto de partida, no la respuesta final. La mejor decisión siempre pasa por probar con tu propio modelo y tus propios datos.
En EOS Ibérica te ayudamos a elegir la plataforma adecuada para tu proyecto de inferencia en el edge, desde mini PC industriales hasta soluciones con GPU y NPU.
Para más información sobre nuestros productos, contacta con nosotros 957 76 12 76 o envíanos tu consulta a través de nuestro formulario de contacto.
En EOS Ibérica ofrecemos soluciones a medida integrando los componentes necesarios para adaptarse a las necesidades de cada proyecto.